导语:内存价格飙升200%,服务器价格上涨125%,交付周期从30天拉长到18个月。这轮短缺的根源不是火灾或疫情,而是超大规模云厂商对AI算力的疯狂吞噬——而且才刚刚开始。CIO无法等到短缺结束,只能在约束中找到出路。
超大规模算力厂商正造成全品类设备短缺,今年内看不到缓解迹象。但分析师、VAR(增值经销商)和供应商对如何在等待心仪设备期间保持AI和其他项目推进,有话要说。
图源:PeopleImages / Shutterstock
交付周期9到12个月,甚至18个月。成本涨幅达到35%、45%,甚至50%到200%。2026年已过半,对企业项目(包括涉及人工智能的项目)至关重要的IT基础设施市场,正处于捉襟见肘的状态。
存储芯片(内存与闪存)是短缺的根源。Gartner(高德纳)的VP(副总裁)分析师Jon Forest(乔恩·福里斯特)表示,内存价格“已上涨50%到200%,导致PC价格上涨35%到45%,部分服务器价格上涨超过125%”。网络交换机也需要内存,尽管需求量低于服务器,但同样未能幸免,价格和交付周期同样大幅攀升。
行业专家一致认为,大部分问题源于超大规模云厂商大肆抢占存储芯片产能,缺口传导至服务器、存储系统和网络设备。不过,尽管问题根源较新,供应链中断并非前所未有。
一、问题有多严重
当前的供应链问题到底有多严重?“相当严重,”行业分析机构Moor Insights & Strategy的副总裁兼首席分析师Matt Kimball(马特·金博尔)表示。习惯于30到45天交付周期的企业,如今需要等待6个月、12个月甚至18个月。
“短缺真实存在,我从各种规模的公司都听到了同样的话,从拥有1000台服务器的企业到拥有10000台服务器的企业都不例外。”Kimball(金博尔)表示。
Gartner的Forest(福里斯特)在发给Network World的邮件中表示:“预计到2027年,内存成本都会持续大幅上涨,到2027年底将占网络硬件支出的25%。”下图展示了Gartner对内存价格走势的时间线预期,Forest(福里斯特)指出,同样的时间节奏适用于网络、存储和计算基础设施。
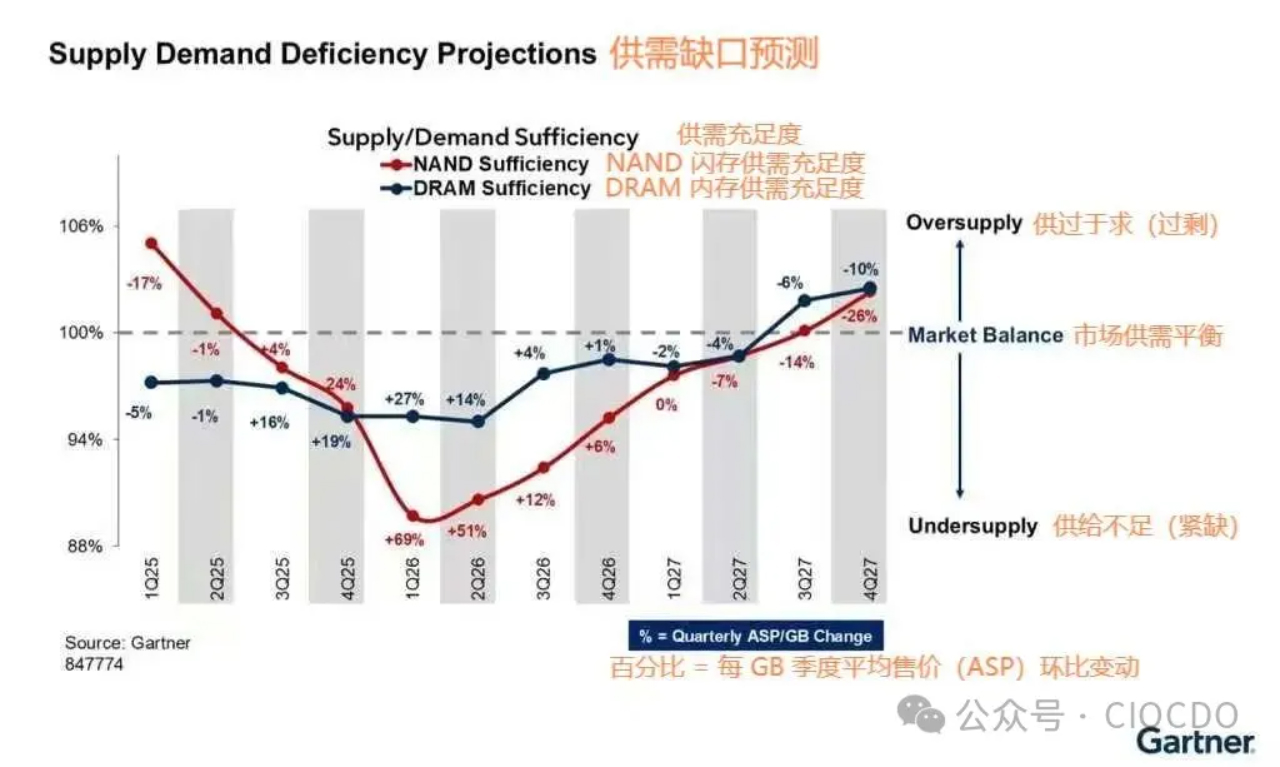
图片[Gartner内存价格走势图]
图源:Gartner
“企业网络设备价格预计在2026年上涨超过20%。预计这一上涨趋势将持续,2027年初将进一步上涨3%到5%,到2027年底前看不到降价迹象。”
但所谓的“降价”更可能是价格“企稳”。
“这是很多人不愿意谈的事。但假设价格上涨了40%,可能只会回落5%,不会下跌40%。”全球IT分销商与增值经销商TD SYNNEX的供应商管理高级副总裁Phillip Privett(菲利普·普里维特)表示。
或许更糟的是,与过去因芯片工厂火灾或新冠疫情造成的中断相比,Kimball(金博尔)称此次短缺更“持久”,因为其根源——AI浪潮——更为持久且才刚刚起步。
“我们正在经历的这波AI推理浪潮才刚刚开始。它将比训练浪潮更长、更大,”他表示,“它影响一切,从AI基础设施到支撑虚拟化和云基础设施的传统设备。”
似乎没有供应商能幸免,即便是Cisco(思科)这样的公司也不例外——它自主设计Cisco Silicon One芯片。或者说,至少它设计芯片,实际制造由TSMC(台积电)完成,而台积电同时也在制造许多其他供不应求的芯片。而芯片只是交换机众多组件中的一个。
另一方面,Cisco从企业销售中获得的利润率远高于超大规模云厂商,因为对后者,Cisco主要只卖硬件,而企业销售通常还包括软件和服务。因此,Cisco有动力保持企业客户的满意度,并维护其在2026年第三季度报告的66%利润率。
尽管如此,Cisco仍须应对与其他供应商相同的短缺问题。
“我不认为有哪家企业情况比其他企业更好,”全球技术服务与解决方案提供商World Wide Technology(WWT)的云、基础设施和AI解决方案副总裁兼CTO Neil Anderson(尼尔·安德森)表示,“部分供应商可能会采用一些微妙的方法在一定程度上平衡处境,但我还没发现哪一家供应商不存在几乎完全一样的问题。”
云存储服务商Backblaze正面临设备成本和供应稳定性问题。Backblaze运营高级副总裁James Rowell(詹姆斯·罗威尔)表示:“多个领域都出现了不同类型的短缺,所有短缺都是由异常的市场需求推动的,实际上就是少数几个体量极大的买家导致的。”
Rowell(罗威尔)称,Backblaze持续预测和监控需求触发因素。这包括与销售团队密切配合预测客户需求,同时参考历史趋势线预测新交易以及现有客户增长带来的即将到来的需求。此外,公司还会关注可能导致利用率飙升的“与市场相关的异常触发因素”。
随着超大规模云厂商大量囤货,“这绝对是一个异常阶段,”Rowell(罗威尔)表示,“在过去大约12个月里,硬件成本涨幅在15%到30%之间,尤其是服务器和计算磁盘的成本涨幅更为明显。”
积极的一面是,至少对Backblaze而言,公司还从一个意想不到的来源获得了业务增长:AI公司。Backblaze市场副总裁Patrick Thomas(帕特里克·托马斯)表示:“我们在上个财报期报告显示,使用我们平台的人工智能企业数量增长了70%,这一增长幅度非常大。”
除此之外,公司还获得了不少无法在本地获得所需存储容量的企业的订单。“整体市场存在不确定性,因此不少潜在订单流向了我们,因为这些机构担心自己无法独立完成存储部署,”Rowell(罗威尔)表示。
尽管有观点认为,目前在建的新芯片制造厂将缓解内存供应紧张,但Privett(普里维特)并不认同该观点。“我认为短期内情况不会好转,”他表示,“新建一座工厂需要两年时间。”
二、应对之道:从基础做起
因此,企业必须打好手上现有的牌。对于曾在佛罗里达州和俄勒冈州担任IT高管的Moor Insights的Kimball(金博尔)来说,第一步是充分利用现有资源。
这种策略“在我接触过的企业中,令人惊讶的是很少得到实施”,“一次简单的容量规划专项分析就能释放大量资源。”这包括利用率仅20%到30%的虚拟化服务器,以及延长现有服务器的使用寿命。虽然15到20年前每四年左右更新一次设备是常态,但如今的服务器通常可以使用六到七年。
虽然这类策略无法解决AI算力挑战,但无疑可以帮助支撑日常运营,并为AI和其他现代化改造项目释放预算,他表示。
“榨干现有资产价值,”TD SYNNEX的Privett(普里维特)赞同这一观点,“尽可能充分利用现有资产,只添置你需要的部分,延长你的许可期限,续签服务协议等等,再多撑一段时间。”
WWT的Anderson(安德森)表示,如果你的企业有预算但买不到想要的硬件,那就买别的东西。“关注那些不依赖这些受限组件的项目,比如软件项目或是SaaS许可,”他表示。
三、与财务团队搞好关系
众多专家建议定期与CFO或财务团队开会,让他们了解你面临的困境,以便公司相应规划。
Gartner的Forest(福里斯特)建议,使用滚动12至24个月预测,并提前与供应商沟通,确认受限制的组件和SKU。他建议通过按季度或按月采购来避免签订长期协议,防止协议有效期跨过2026年这一轮价格快速上涨周期。
Privett(普里维特)还建议与设备供应商的金融部门合作,不少供应商都推出了融资优惠。尤其是计算设备供应商,会提供补贴融资、延期付款,以及第一年左右的低成本融资。“这些都是值得把握的重大机会,”他说。
通过与财务团队对接,IT部门可以开展预算分配演练,想办法让财务层面可行。你最不应该做的就是突然向他们提出额外的预算申请,打他们一个措手不及。
Kimball(金博尔)回忆了他供职于佛罗里达州政府期间的经历,当时所有预算申请都要经过一个技术审查工作组的审核,该工作组的设定就是持对立审视态度。
“我没法想象去找他们说‘哦,我之前说的是100万美元?其实是200万,我需要你们给我批更大的支票’,我宁愿走进塔拉哈西的一片沼泽被鳄鱼吃掉,也不会干这种事。”他说。
四、与供应商和增值经销商协作
在制定计划时,多向供应商寻求帮助,包括VAR和全国性经销商等渠道合作伙伴。“和他们一起梳理规划,理清你的工作负载规模会是什么样,”Kimball(金博尔)表示。
Backblaze的Rowell(罗威尔)就是定期这样做的。他会向供应商列出自己的年度预测,包括Backblaze确定采购的承诺量,也会涵盖两倍增速这类高速增长场景。“然后他们会回复‘没问题’,或者可能会说我们需要立刻分配配额,否则我们后续可能拿不到需要的货。”他表示。
同样,他会定期和首席财务官一起制定预测模型,把通胀、涨价这类因素都纳入考量。核心思路是提前规划多种情景,避免措手不及。
“如果你不这么做,就会陷入非常被动的境地——也就是陷入被动,没有足够产能抓住市场机会。”他说。
获取满足项目需求所需的产能,可能还意味着在设备选择上保持灵活。如果你是Dell(戴尔)的用户但买不到Dell服务器,也许可以考虑Lenovo(联想),Kimball(金博尔)表示。
“你必须想办法以异构的方式利用所有这些芯片和基础设施来满足你的需求,”他表示。这对AI基础设施尤其如此。“如果你认为从RAG(检索增强生成)到边缘推理都要用100%的Nvidia,那你有点异想天开,不是因为成本,而是因为可获得性。”
关注替代方案,包括AMD和云解决方案,同时注意它们之间的协同。你可能拿不到Nvidia的GPU,但AWS、Azure和Oracle Cloud有,Kimball(金博尔)指出。
采取策略性做法,比如利用云服务处理某些调优或推理工作负载,然后在合适时机回迁本地自建环境。“你要更清楚哪些业务必须放在本地部署,哪些可以放在云端,”他表示。
Backblaze的Thomas(托马斯)表示这是很好的建议。在AI方面,要考虑性能层级和你拥有的各类用例,并不是所有用例都需要顶级性能。
“人们总执着于追求顶级配置,但边缘场景其实有很大灵活度,不同软硬件都有创新空间。”Thomas(托马斯)表示。
Gartner同样建议企业提高配置灵活性并拓宽采购渠道。Forest(福里斯特)表示,这可能包括从二级市场和租赁返还计划中采购,以维持现有基础设施的连续性,直到短缺过去。
五、先动起来
即使无法获得或需要等待所需的基础设施,也不要让这阻止你启动AI或其他现代化改造项目。
Anderson(安德森)表示,可选方案包括公有云和neocloud(新云)服务商。WWT也在自有实验室开放算力,让客户可以先启动概念验证项目。“不要直接放弃,我们可以帮你找到算力,”Anderson(安德森)表示,“生产级AI的部署可能会延迟,但不要让它打乱你的整体战略。”
主机托管提供商也可能是一个选项,尤其是当企业难以获取高端网络设备时。网络是主机托管提供商的核心价值主张,因为它们已内建与各种云服务商和其他生态参与者的连接。
例如,Equinix(全球数据中心与互联平台提供商)在77个都市区拥有280个数据中心,公司主机托管产品管理高级总监Phil Read(菲尔·里德)表示。如果你有计算基础设施,Equinix可以在数据中心内部和边缘设施中帮助你实现所需的高端连接。
它还与Cisco和Nvidia合作,提供“现成可用的AI连接”方案,Read(里德)表示。这意味着Equinix能够适配功率密度与散热要求,提供符合高端计算解决方案需求的合适基础设施。这类方案对功率密度要求极高,单个机架需要120kVA以上的供电容量。“目前业内关于兆瓦级机架的讨论非常多,”他表示。
Privett(普里维特)指出,电力供应是整个议题中至关重要的问题。老旧的计算基础设施可能消耗远高于新系统的电力,这构成了尽快升级的理由。
“如果现在完成基础设施现代化改造,你就可以在支撑相同应用的前提下,大幅减少所需服务器数量,同时获得低得多的能耗水平,”Privett(普里维特)表示。他建议与OT(运营技术)团队的相关人员充分对接,确保计划开展的任何项目都有充足的电力保障。在全球很多地区,电力资源都非常紧缺。
如果你的计划包括在自己的数据中心部署GPU环境,WWT建议不要拖延。Anderson(安德森)表示:“我们现在对客户说的就是,你需要尽快和我们对接,完成方案设计、下单排期,因为从下单到实际发货、完成安装需要相当长的周期。”
Moor Insights的Kimball(金博尔)表示同意。“如果你想在12个月后看到这些部件运抵你的码头、仓库或办公室,今天就得下单。”