导读:当人工智能从“回答问题”迈向“自主执行”,仅靠堆砌原始数据已远远不够——它必须真正“读懂业务”。一项诞生已久、曾一度被视为投入产出比不高的底层技术,正在代理式 AI(
Agentic AI)时代迎来价值重估:已有领先企业借此在项目第一年便实现 1,000 万美元的成本节约。
传统关系型数据库将数据组织为二维表格:一列记录人员姓名,另一列记录其所属公司。而图数据库(Graph Database)存储同类信息时,摒弃了表格形态,转而采用“节点(Node)”与“边(Edge)”的结构——人员是一个节点,其所在的公司是另一个节点,连接两者的“边”则精准刻画了他们之间的关联关系。
[图片 1:(图数据库与知识图谱的节点及关联网络示意图。图源:Macrovector / Shutterstock)]
任意节点均可与其他节点建立连接,这赋予了图数据库极高的架构灵活性。检索关联实体时,系统只需沿着“边”从一个节点遍历至另一个节点。这一特性在梳理复杂供应链依赖、识别金融欺诈、映射用户偏好以优化推荐引擎等业务场景中表现尤为突出。
仅凭底层存储结构,图数据库对 AI 智能体(AI Agents)而言就已具备巨大的潜在价值,但企业级数据架构的演进远不止于此:
知识图谱(Knowledge Graph):构建在图数据库之上的关系网络,明确定义了实体间连接的性质。例如,人员节点与公司节点之所以相连,是因为该人员是这家公司的员工。知识图谱核心解决的是“这些数据是什么”的问题。
语义图谱(Semantic Graph/ Semantic Knowledge Graph):在此基础上更进一步,为关系注入了深层的商业语义。例如,这份公司清单在业务上实为“现有客户或潜在商机池”,人员清单则是“销售外呼的关键联络人”,而其职位头衔直接映射了决策链路中的权重与相对重要性。
语义层(Semantic Layer):聚焦于更高维度的企业级数据治理——这些数据对企业经营究竟意味着什么,以及在真实业务实践中应当如何被调用。当 AI 智能体被委以重任、真正接管端到端业务操作时,它们必须掌握这套认知体系。
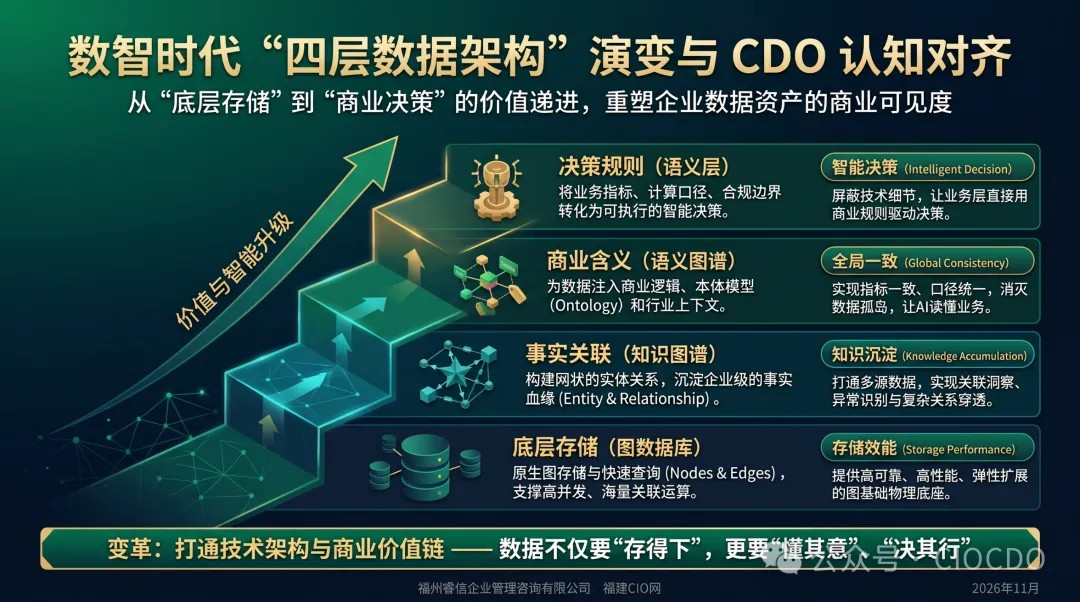
数智时代“四层数据架构” @福建CIO网
“代理式 AI(自主型AI智能体-Agentic AI)是能够执行实质性业务操作的 AI,而不仅仅是停留在输出文本答案的 AI,”全球建材制造巨头 Cosentino 首席信息官(CIO)Rafael Domene(拉斐尔·多梅内)指出,“但你必须以正确的方式,向 AI 提供其履职所需的核心要素。这绝不仅仅是原始数据,而是经过提炼的业务信息——关乎企业的运作机理,更关乎精准理解当下正在发生什么。”
Cosentino 此前已在庞大的数据湖(Data Lake)、湖仓一体架构(Data Lakehouse)以及企业资源计划(ERP)和客户关系管理(CRM)系统上投入了巨额资金。“你可以将全公司的数据全部归集起来,但这依然不足以解释业务现场究竟发生了什么,”他说,“当某项关键绩效指标(KPI)亮起红灯时,管理者往往不得不深入组织内部逐层排查根因。”在传统模式下,这一过程高度依赖对公司运作逻辑了如指掌的人类专家。那么,如何通过 AI 将这一研判过程自动化?
答案在于:语义层将数据背后隐含的“业务上下文(Business Context)”完整地交给了 AI。
回顾历史,构建企业级语义层一直是一项极其繁重的苦差事。它需要领域业务专家(Subject Matter Expert, SME)的深度介入,而且绝非一劳永逸的静态项目——因为企业的运作模式始终处于动态演变之中。在过去,这笔投入往往显得性价比不高,尤其是当使用这些数据的业务分析师本身就深谙业务背景时:他们自带“人类理解力”,并不迫切需要一套显性化的语义层。
然而,AI 智能体并不具备这种与生俱来的业务直觉。它们对企业通用运营模式的认知十分有限,对某一家特定企业的独特业务流转逻辑更是知之甚少。
Cosentino 于三年前启动了语义层建设项目,计划于今年年底全面完工。“目前,涵盖物流、制造、运营、客服与销售、采购及人力资源(HR)在内的核心业务流程与数据流转均已就位,剩余的收尾工作主要集中在财务相关板块。”Domene 介绍道。
他表示,这项前瞻性投入已经结出硕果。以一笔延迟交付的订单为例:“订单履约直接关乎客户服务水平,”Domene 解释道,“但这一端到端流程横跨 15 个部门,每个部门都守着各自独立的业务看板。过去,我们常常直到最后一刻才惊觉某笔特定订单无法按期交付。”
如今,依托语义层,AI 智能体可以实时透视任何一笔订单与任何一位客户,精准预测该订单能否准时送达;一旦识别出延误风险,还能瞬间定位阻滞点究竟卡在哪个环节。
“如果原材料未能按时到厂,或者产线突发异常,后续流程就不可能按期触达客户,”他说。但如果一线销售人员在风险冒头的第一时间就能收到预警,他们就可以主动联系客户,坦诚说明情况并迅速提出可行的替代方案。
“这绝不仅仅是信息同步,”Domene 强调,“缺乏业务上下文,我就无法将孤立的数据点串联成决策链条。这个流程到底出了什么状况?这笔订单为什么与上一笔表现不同?背后的根因是什么?我能采取哪些干预措施?最优的行动方案是什么?——唯有理清这些逻辑,我们才能为特定客户或产品做出最正确的商业决策。”
再比如,当某位客户超出信用额度导致订单被系统自动冻结时,过去这一异常处理流程平均会造成长达 22 天的交付延误;而如今,最长的处理延迟已压缩至不超过一天。
“这直接带来了客户服务水平与运营绩效的双重跃升,”他表示,“过去财务部专门配备了一支团队来人工跟进这类异常订单。现在,他们得以从中彻底解放出来,将精力投入到对客户更具战略价值的高阶工作中。”
据 Domene 透露,该项目在落地的第一年,便为公司实现了高达 1,000 万美元的成本节约。“投资回报来得非常快,”他说,“而且收益远不止于降本,它还会对我们的顶层营收产生正向拉动。”
他预计,到今年年底,该项目累计为公司带来的成本节约将攀升至 1 亿美元。此外,隐性收益同样可观:例如,一线销售人员过去不得不将超过三分之一的工作时间耗费在繁琐的行政事务上,而很快就会有专属的 AI 智能体来协助处理这些工作。Cosentino 已于去年启动这批销售智能体的构建,今年完成测试验证,预计很快将在全公司全面上线。
“并非所有释放出来的工时都能直接转化为当期营收,”Domene 客观地指出,“我们仍需观察最终的业务转化成效,但其中蕴含的巨大潜力已清晰可见。”
在知识图谱与语义层项目启动初期,构建工作很大程度上仍是一个人工主导的过程——由企业内部的业务专家牵头,并与项目选定的流程挖掘(Process Mining)供应商 Celonis 的工程团队协同推进。“像 SAP(思爱普)这类核心系统本身具备高度标准化的流程与上下文,梳理起来相对容易,”Domene 表示,“但它依然离不开扎实的人力投入。”随着底座逐步成型,AI 才开始介入并为团队持续增效。
值得注意的是,语义层的构建目前尚不具备“全自动完成”的条件。
“面对人类以非结构化方式编写的各类业务文档,AI 并不总能准确提取出其中隐含的语义关系,”SANS Institute 研究员、Enclave Forensics 运营主管 David Hoelzer(大卫·赫尔泽)指出。AI 确实可以加速知识图谱的搭建并辅助其日常更新,但放任 AI 在无人监督下完全自行构建将是一个严重的架构失误。“它最终很可能会拼凑出一些毫无业务逻辑的错误关联,”他警告道,“在这个环节,你依然离不开人,而且是具备特定跨界技能的专业人才。”
大约在一年前,向大语言模型(LLM)注入企业专有信息的行业标准范式,是采用检索增强生成(RAG)架构并搭配向量数据库(Vector Database)。企业将可能对 AI 有价值的非结构化文档切分并转化为向量存入数据库,使语义相近的内容在向量空间中自动聚类。这样,当提示词发送给大模型时,系统就能自动附带相关的参考上下文。
传统的 RAG流水线至今依然具备实用价值,但在企业级智能体场景下,其局限性日益凸显:它往往会一次性召回大量冗余材料,其中夹杂的陈旧信息或冲突内容极易让大模型产生混淆;同时,塞入过多的上下文意味着更高的词元(Token)消耗与算力账单。由于 AI 智能体在执行复杂任务时会高频次调用大模型,上下文信息冗余已成为制约性能与成本的大忌。相比之下,知识图谱能够帮智能体精准锚定所需的确切事实,而语义层则进一步赋予它们“拿到信息后该如何决策与行动”的业务规则。
纽约人寿集团福利解决方案部(New York Life Group Benefits Solutions)采取了“向量数据库 + 知识图谱”双轨并行的混合架构。其知识图谱构建在 LangChain旗下的 LangGraph智能体框架之上。
“知识图谱负责多智能体协同编排(Multi-agent Orchestration),而向量数据库则服务于生成式 AI 的 RAG检索应用,”该公司 CIO Matt Marze(马特·马尔泽)清晰地界定了两者的分工边界。
在该公司的架构实践中,知识图谱从基础业务信息、结构化数据、实时运行信号以及外部数据源(例如保险经纪人社区动态)起步;随后,语义层在其上注入深度的业务理解、实体间的逻辑关联,以及围绕保险产品与福利计划建立的全局统一口径(Common definitions)。Marze 补充道,语义层还全面纳管了当前态势的业务上下文、历史沿革、标准工作流以及业务优先级。
“所有这些要素最终汇流为可执行的业务洞察、趋势预测与行动建议,使我们能够高效统筹并编排各个 AI 智能体的协同能力,”他表示。
随着企业级代理式 AI 项目的井喷式增长,市场对知识图谱的关注度正在持续升温。
“一年半前,当我向客户推介这套架构时,人们看我的眼神仿佛我在讲天方夜谭,”麦肯锡(McKinsey & Company)杰出合伙人 James Kaplan(詹姆斯·卡普兰)回忆道,“但在过去一年里,我们见证了知识图谱应用在企业界的真实爆发。我接触过的许多大型机构都已经意识到,他们可以依托知识图谱支撑更复杂的商业决策,并将其与智能体深度融合,打造出真正具备高阶执行力的企业级 AI。”
输出准确性不足与模型幻觉(Hallucination),是所有生成式 AI 模型共同面临的顽疾;而在需要连续多次调用大模型的自主智能体系统中,单步微小的误差会在链条传递中被迅速累积和放大。
“所有大语言模型在本质上都是概率性的(Probabilistic),”安永(EY)美洲区工业与能源板块数据与 AI 负责人、合伙人 Zakir Hussain(扎基尔·侯赛因)指出,“一旦你试图依赖这些模型去回答严肃的企业级业务问题,或者基于其输出结果做出关键商业决策,它们就会开始产生幻觉——因为在绝大多数情况下,它们并不真正理解、甚至严重误读了企业的业务上下文。”
这一痛点在企业核心业务场景中表现得尤为尖锐,因为通用大模型是基于互联网公开的泛化信息训练而成的。“一旦落地到某家企业的特定业务规则与边界条件中,各类水土不服的问题便会集中暴露,”他补充道。
根据加州大学圣芭芭拉分校(UC Santa Barbara)与摩根大通 AI 研究院(JP Morgan AI Research)于 2025 年底联合发布的一项权威研究论文,在复杂推理任务中,引入知识图谱相比标准的思维链(Chain-of-thought, CoT)基线,可将模型准确率提升 26% 以上。
“当下行业内围绕企业本体(Ontology)、语义层与知识图谱展开的这场深度探讨,具有极其重要的战略意义,”Hussain 总结道。如今,每一家组织都在竭力探索如何借助 AI 实现业务增长、运营效率与全员生产力的跃升。“而要真正解锁这三重价值,企业必须对自身的业务上下文进行形式化编码(Formalized encoding)。”
Graph Database (图数据库):以“节点(实体)”和“边(关系)”而非传统二维表格形式存储数据的非关系型数据库,擅长高效处理高度互联的复杂网络查询(如供应链穿透、风控反欺诈)。
Knowledge Graph(知识图谱):构建在图数据库之上的结构化语义关系网络,通过定义实体属性与关系类型,让机器精准理解“数据是什么、实体之间存在何种客观关联”。
Semantic Layer (语义层):位于底层数据基础设施与上层分析/AI 应用之间的抽象治理层。它将冰冷的数据库字段映射为统一的企业级商业指标、业务口径与操作规则,是 AI 智能体读懂业务上下文的核心桥梁。
Ontology (企业本体):源于哲学与信息科学的顶层建模概念,在企业级 AI 中指对组织内所有核心业务对象(如客户、订单、产线)、属性、逻辑关系及决策动作进行的高度形式化、机器可读的全局数字定义。
Process Mining (流程挖掘):通过抓取 ERP、CRM等核心业务系统的事件日志(Event Logs),客观还原企业真实业务流转路径、定位卡点与隐性延迟的数据分析技术(代表厂商如 Celonis),常作为构建企业语义层的先行工具。
Vector Database & RAG (向量数据库与检索增强生成):Vector Database将非结构化文本转化为数学向量并按相似度聚类存储;RAG则在调用大模型前先检索相关片段作为参考上下文。两者适合模糊语义匹配,但在高频调用的智能体场景下易出现信息冗余、成本飙升及事实冲突。
Multi-agent Orchestration (多智能体协同编排):将复杂业务流程拆解并分配给多个专职 AI 智能体(如风控、排产、客服智能体),依托图谱与状态机(如 LangGraph)统一调度其执行顺序、状态流转与异常交接的架构模式。
Chain-of-thought (CoT / 思维链):引导大语言模型在给出最终答案前,分步骤显式输出中间推理过程的提示工程与推理范式。结合知识图谱约束后,可大幅降低长链路推理中的幻觉累积率。
作者简介:Maria Korolov(玛丽亚·科洛洛夫)是一位屡获殊荣的科技记者,长期专注报道人工智能与网络安全领域。工作之余,她亦是一位科幻小说作家,担任科幻与奇幻杂志主编,并主持一档 YouTube 频道。
过去十年,众多企业斥巨资建成了庞大的数据湖与湖仓一体底座,却在落地代理式 AI(Agentic AI)时屡屡受挫——根源在于,数据湖只解决了“存得下”,却没有把人类专家头脑中的隐性业务规则转化为机器可读的“业务上下文”。当 AI 从被动问答转向自主执行,缺乏约束的纯向量 RAG极易因信息过载与概率性误差累积,演变为高成本的“幻觉放大器”。
对于 CIO 与 CDO 而言,Cosentino 首年降本千万美元与纽约人寿的实战提供了清晰破局路径:
1、架构上确立“双轨协同”:摒弃用单一向量库包打天下的幻想,由向量数据库承接非结构化文档的模糊检索,由知识图谱与语义层负责精准事实锚定、规则约束与多智能体编排。
2、实施上以“流程挖掘”切入高价值闭环:切忌将语义层做成大而全的纯 IT 工程,也不可放任 AI 全自动生成关系。应依托 ERP等标准化系统,借力流程挖掘(Process Mining)联合业务专家,优先打通订单履约、信用风控等跨部门堵点,以可量化的首年 ROI 驱动企业“本体(Ontology)”资产的滚雪球式沉淀。